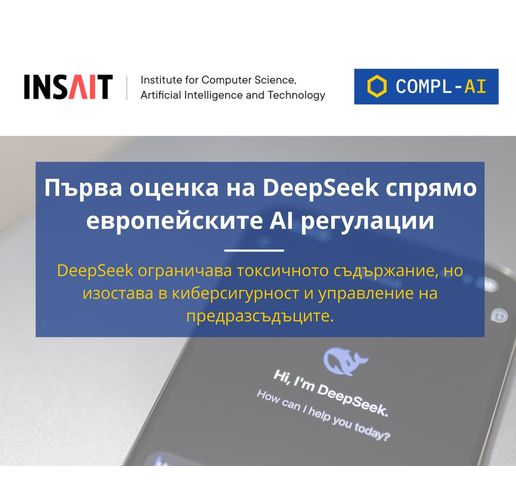



Сериозни пропуски в съответствието на дестилираните модели на DeepSeek съгласно Европейския акт за изкуствения интелект (EU AI Act). Това устанява изследване на Института за изкуствен интелект и компютърни технологии (INSAIT) към Софийския университет проведено съвместно с водещата технологична компания LatticeFlow. Дестилацията на големи модели кaто DeepSeek в по-малки е стандартен процес който ги прави много по-практични и по-ефикасни за бизнеса и организациите.
Припомняме, че двете организации, заедно с швейцарския университет ETH Zurich създадоха COMPL-AI - първата рамка в ЕС, която превръща регулаторните нормативни изисквания в конкретни технически проверки. Чрез нея се тестват някои от най-популярните модели за изкуствен интелект, за да се оцени съответствието им съгласно европейските правила (OpenAI, Meta, Google, Anthropic, Mistral AI и Alibaba).
Дестилираните модели на DeepSeek постигат добри резултати в ограничаването на токсичното съдържание, но изостават в ключови регулаторни аспекти като киберсигурност и управление на предразсъдъците. Това повдига въпроси относно тяхната готовност за внедряване в корпоративна среда.
Оценката, проведена съвместно с LatticeFlow AI, обхваща два от най-популярните дестилирани модела на DeepSeek: DeepSeek R1 8B (базиран на Meta’s Llama 3.1 8B) и DeepSeek R1 14B (базиран на Alibaba’s Qwen 2.5 14B) - двата с близо 400 000 изтегляния. Тя показва и как DeepSeek моделите се сравняват с тези на OpenAI, Meta, Google, Anthropic, Mistral AI, Alibaba и др.
Крайните резултати показват, че тези DeepSeek модели заемат последните места в класацията в сравнение с другите тествани модели по отношение на киберсигурност. Те показват повишени рискове от "отвличане на цели" (goal hijacking) и "изтичане на промптове” (prompt leakage) в сравнение с базовите си версии. Това може да е проблем не само защото увеличава вероятността AI моделът да бъде подведен да изпълнява непредвидени действия (отвличане на цели), но и защото увеличава риска от разкриване на поверителна информация (изтичане на промптове). В резултат, тези слабости намаляват надеждността на моделите и правят използването им в сигурни бизнес среди значително по-рисковано.
DeepSeek моделите са и под средното ниво в класацията по отношение на пристрастност и показват значително по-големи предразсъдъци от своите базови модели. Оценката за пристрастност (bias) при AI моделите измерва доколко техните отговори са обективни, неутрални и справедливи спрямо различни социални, културни, етнически, полови и политически групи. В случая с DeepSeek моделите, резултатите показват, че те са под средното ниво в класацията или с други думи - моделите проявяват по-силни предразсъдъци в сравнение с други AI модели, тествани от COMPL-AI.
Нещо повече, те показват значително по-големи предразсъдъци от своите базови модели – тоест в процеса на модифициране DeepSeek моделите са се влошили в този аспект в сравнение с оригиналните модели Llama 3.1 (Meta) и Qwen 2.5 (Alibaba). Това може да е проблем не само защото ще генерират небалансирани отговори по чувствителни теми, но и да насърчават дезинформация по различни теми.
Въпреки останалите пропуски, моделите на DeepSeek показват добри резултати в управлението на токсичността, надминавайки дори своите базови версии. Оценката за токсичност в контекста на AI модели се отнася до способността на един езиков модел да идентифицира, минимизира или предотврати генерирането на вредно, обидно или неприемливо съдържание. Това включва съдържание, което може да бъде расистко, сексистко, дискриминационно, заплашително или по друг начин вредно за потребителите.
В случая с оценката на DeepSeek моделите чрез COMPL-AI, беше установено, че те се справят добре с ограничаването на токсично съдържание, дори по-добре от своите базови модели (Meta’s Llama 3.1 и Alibaba’s Qwen 2.5). Това означава, че те по-рядко генерират неподходящ или обиден текст, което е важен аспект за съответствието им с регулациите на EU AI Act.
Пълните резултати от оценката на INSAIT и DeepSeek са достъпни на https://compl-ai.org)